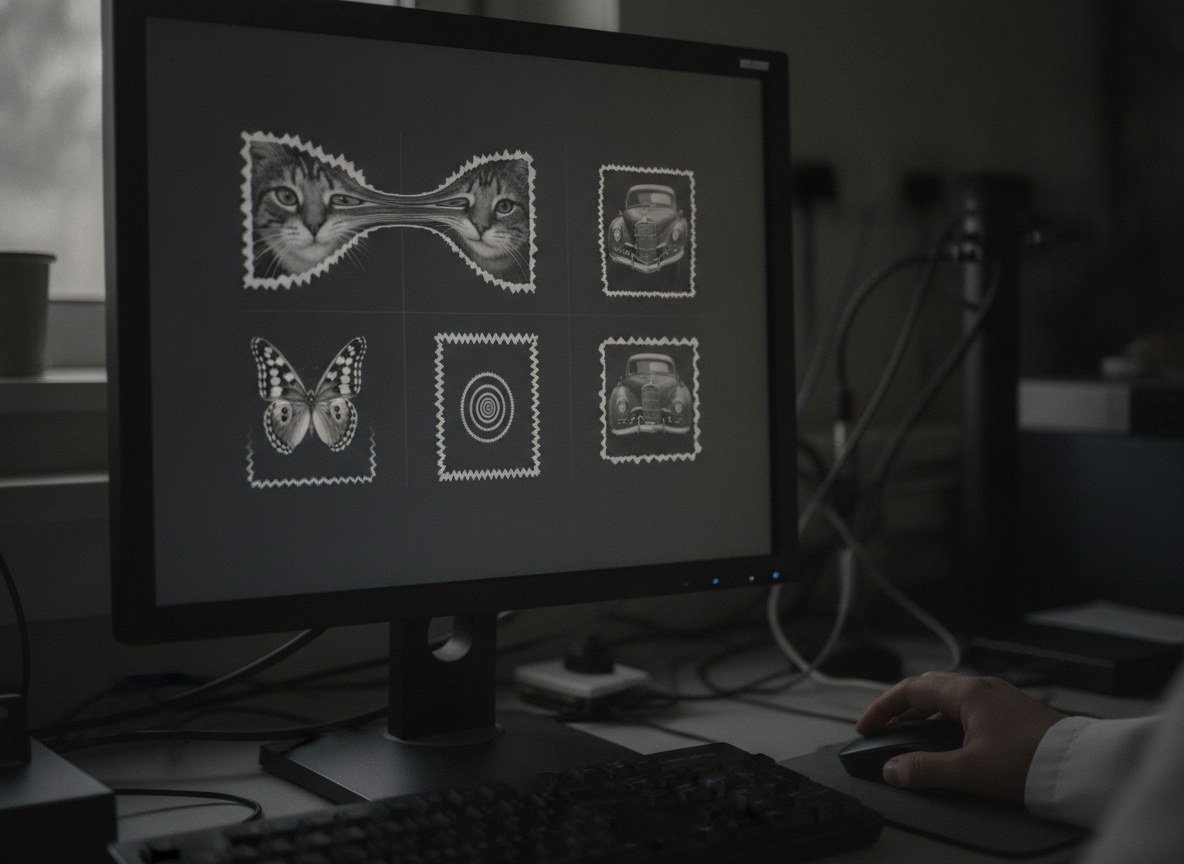
Els grans models de visió per ordinador s'avaluen sobretot per la seva precisió final a l'hora d'identificar objectes en una imatge, però se sap molt menys sobre si hi arriben pel mateix camí que ho fa la percepció humana, en particular si es basen en la forma global de l'objecte o més aviat en textures i detalls locals.
Un equip encapçalat per Biyu J. He, de la Universitat de Nova York, va posar a prova més de dues-centes xarxes neuronals profundes de visió per ordinador i les va comparar amb persones voluntàries. Els investigadors van distorsionar sistemàticament imatges de gats, papallones, cotxes i panotxes de blat de moro, alterant-ne per separat la forma global, les parts internes i les textures, i van mesurar qui identificava millor l'objecte en cada condició. L'estudi, publicat el 17 de setembre a la revista «iScience» del grup Cell Press, conclou que els humans superen sistemàticament tots els models d'IA quan la identificació depèn de reconèixer la forma global de l'objecte, i que cap dels dos-cents models reprodueix del tot el patró humà de reconeixement.
«La capacitat humana d'aprofitar la forma global com a pista per al reconeixement visual d'objectes continua sent inigualada», resumeix He. La troballa suggereix que, malgrat entrenar-se amb quantitats massives d'imatges, els sistemes de visió per ordinador actuals encara no estan del tot alineats amb la manera humana de veure el món, una qüestió rellevant per a aplicacions on la forma importa especialment, com la conducció autònoma o la lectura d'imatges mèdiques.
L'estudi es limita a un conjunt concret de categories d'objectes i a distorsions dissenyades expressament en laboratori, i no inclou necessàriament els sistemes multimodals més recents. Els autors no en treuen que la IA sigui inservible per a tasques de visió, sinó que segueix una estratègia de reconeixement diferent de la humana, cosa que caldrà tenir en compte a l'hora d'interpretar-ne els encerts i els errors.