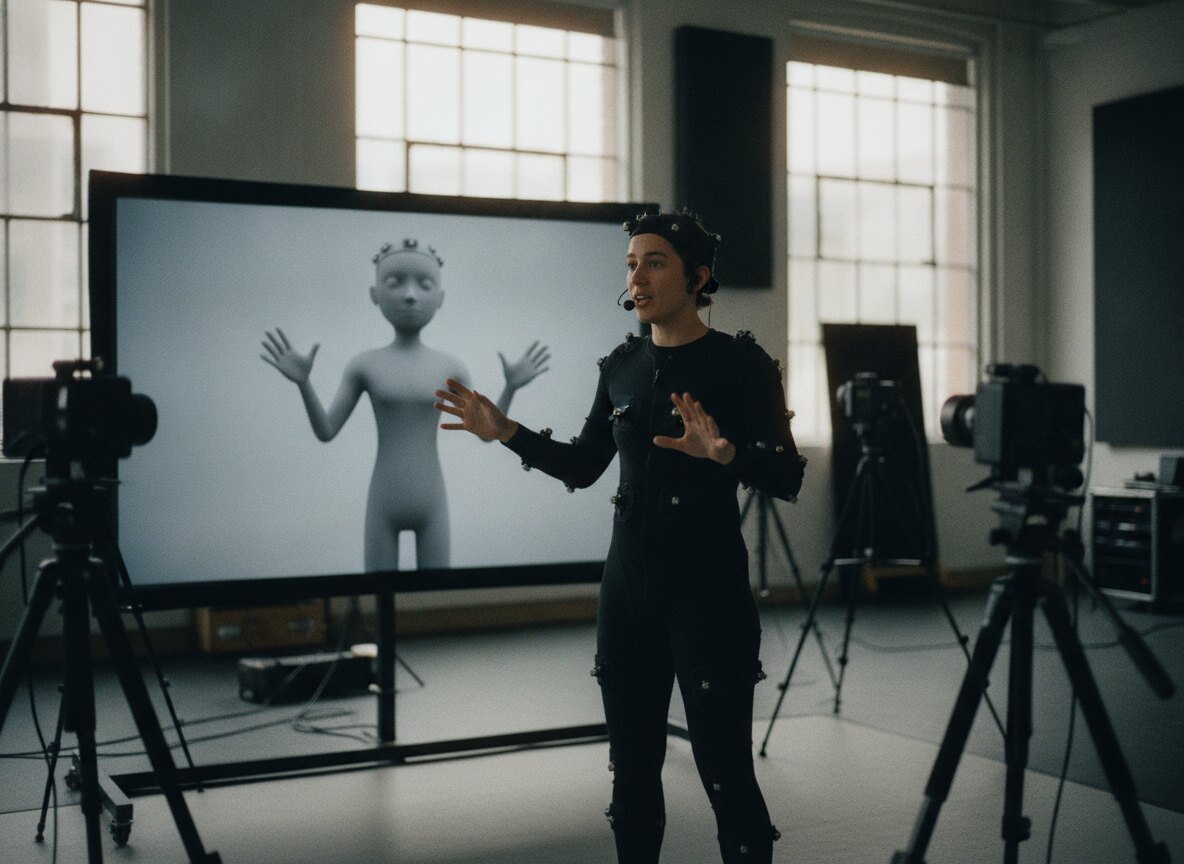
Els presentadors virtuals, els avatars dels assistents d'IA i els personatges dels videojocs parlen cada vegada millor, però sovint es mouen malament: gesticulen a destemps, repeteixen els mateixos gestos o es queden rígids en un discurs llarg. Fer que el cos, les mans i la cara acompanyin la veu de manera creïble és un dels problemes oberts de la infografia.
Un equip de la Universitat de Tohoku, al Japó, i de la Universitat de Hong Kong, amb Yifei Zhu com a primer autor, ha publicat a la revista ACM Transactions on Graphics un sistema anomenat DynaConTalk, que es presentarà al congrés SIGGRAPH Asia de Kuala Lumpur de l'1 al 4 de desembre. A partir d'una gravació de veu, genera en tres dimensions els moviments del cos, les mans i la cara. Per fer-ho, separa els moviments lents dels ràpids —com quan es distingeixen els greus dels aguts d'un so— i els modela junts perquè no es desincronitzin. També dosifica el pes que dona al ritme, al timbre de la veu i a les paraules, i té en compte el moviment que ja ha generat perquè el personatge no perdi la coherència en una intervenció llarga.
Els autors el van avaluar amb dues col·leccions públiques de moviment humà i amb una prova en què 30 persones van comparar tres sistemes amb 15 fragments de veu. DynaConTalk va obtenir la millor valoració mitjana en els quatre aspectes que es demanaven: naturalitat, relació amb el que es diu, sincronia i varietat de moviments. Les mesures automàtiques també van indicar que els seus moviments s'assemblen més als d'una persona real. L'usuari, a més, pot guiar el resultat indicant postures o moviments de referència.
La informació publicada no dona puntuacions numèriques, i la prova amb persones és petita. El sistema encara no genera desplaçaments de tot el cos, com caminar, perquè les col·leccions de dades tenen pocs exemples de moviments amplis i la veu sola no diu cap on s'ha de moure el personatge. L'equip vol fer-hi servir dades més grans i afegir-hi indicacions de trajectòria. L'article té el DOI 10.1145/3842553.