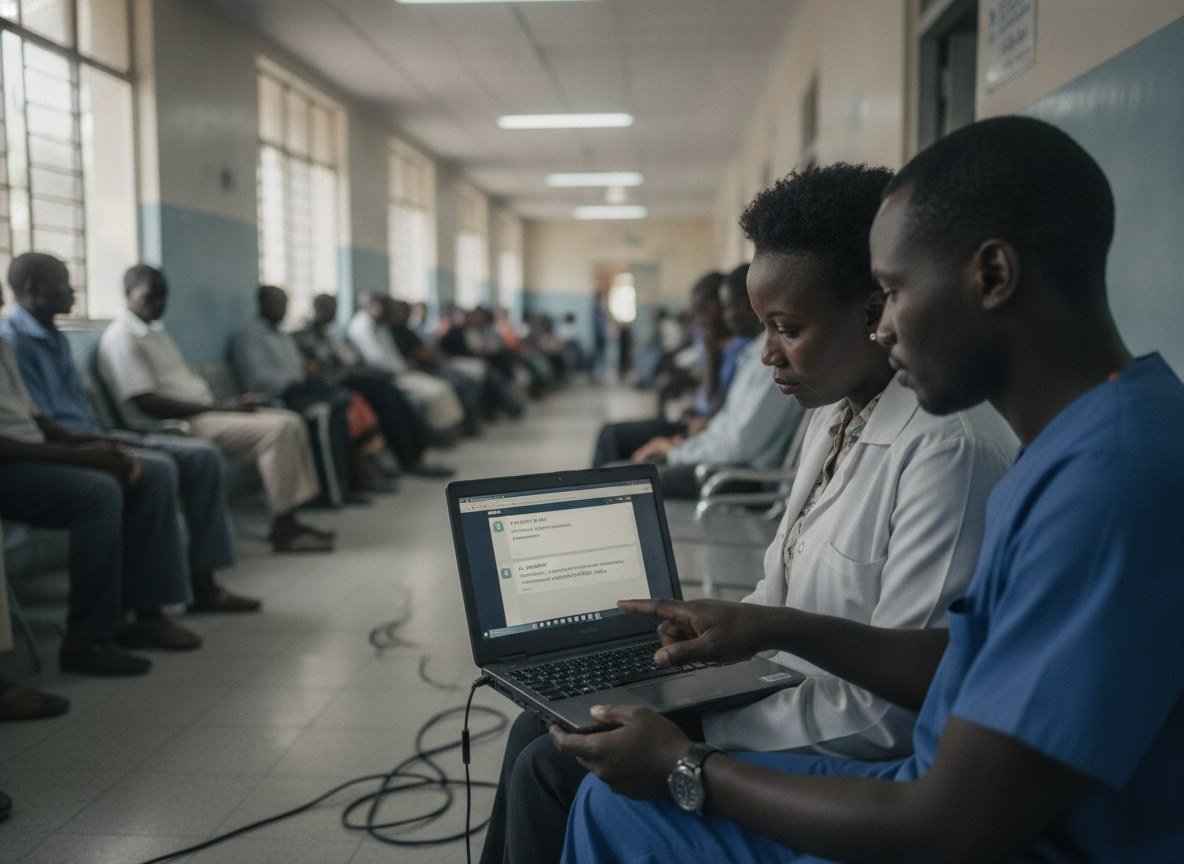
Els grans models de llenguatge ja s'estan provant com a suport a la decisió clínica arreu del món, però la majoria d'assaigs que en mesuren l'efecte s'han fet en hospitals de països rics, amb metges que ja disposen de temps, formació i recursos diagnòstics abundants. Un equip internacional amb investigadors de la Universitat d'Indonèsia, l'Institut Indonesi d'Educació i Recerca Mèdica i la Universitat de Maastricht ha volgut comprovar si l'ajuda d'un model de llenguatge es comporta igual en entorns clínics molt més diversos.
L'estudi, publicat el 9 de setembre a la revista «npj Digital Medicine», del grup Nature, és un assaig controlat i aleatoritzat en paral·lel amb 249 metges repartits entre Kenya (60), Indonèsia (81) i els Països Baixos (108), majoritàriament residents de medicina interna o familiar. Els participants es van assignar a l'atzar a un grup de control o a un grup amb accés a GPT-4o per resoldre casos clínics. Els resultats mostren una millora del rendiment clínic en els tres països, però amb diferències notables: 18 punts percentuals a Kenya (interval de confiança del 95%: 12,7 a 23,2; p<0,001), 10,7 punts a Indonèsia (5,7 a 15,7; p<0,001) i 7,2 punts als Països Baixos (3,7 a 10,7; p<0,001).
La troballa és rellevant perquè inverteix una part de la narrativa habitual sobre la IA a la medicina: en lloc de beneficiar sobretot els sistemes sanitaris més ben dotats, l'ajuda del model va tenir el màxim impacte precisament on els metges tenen menys accés a especialistes, proves complementàries i segones opinions. És una de les primeres evidències experimentals directes, amb un disseny aleatoritzat i multipaís, que un model de llenguatge genèric pot reduir bretxes de qualitat assistencial entre entorns econòmicament molt diferents, i no només fer més eficients els hospitals que ja funcionen bé.
L'estudi mesura el rendiment en la resolució de casos clínics, no l'efecte final sobre pacients reals ni sobre resultats de salut a llarg termini, i es limita a metges en formació o d'atenció primària en tres països concrets, de manera que caldrà comprovar si les diferències es mantenen amb altres especialitats, altres models d'IA o en la pràctica clínica del dia a dia, fora de l'entorn controlat d'un assaig.