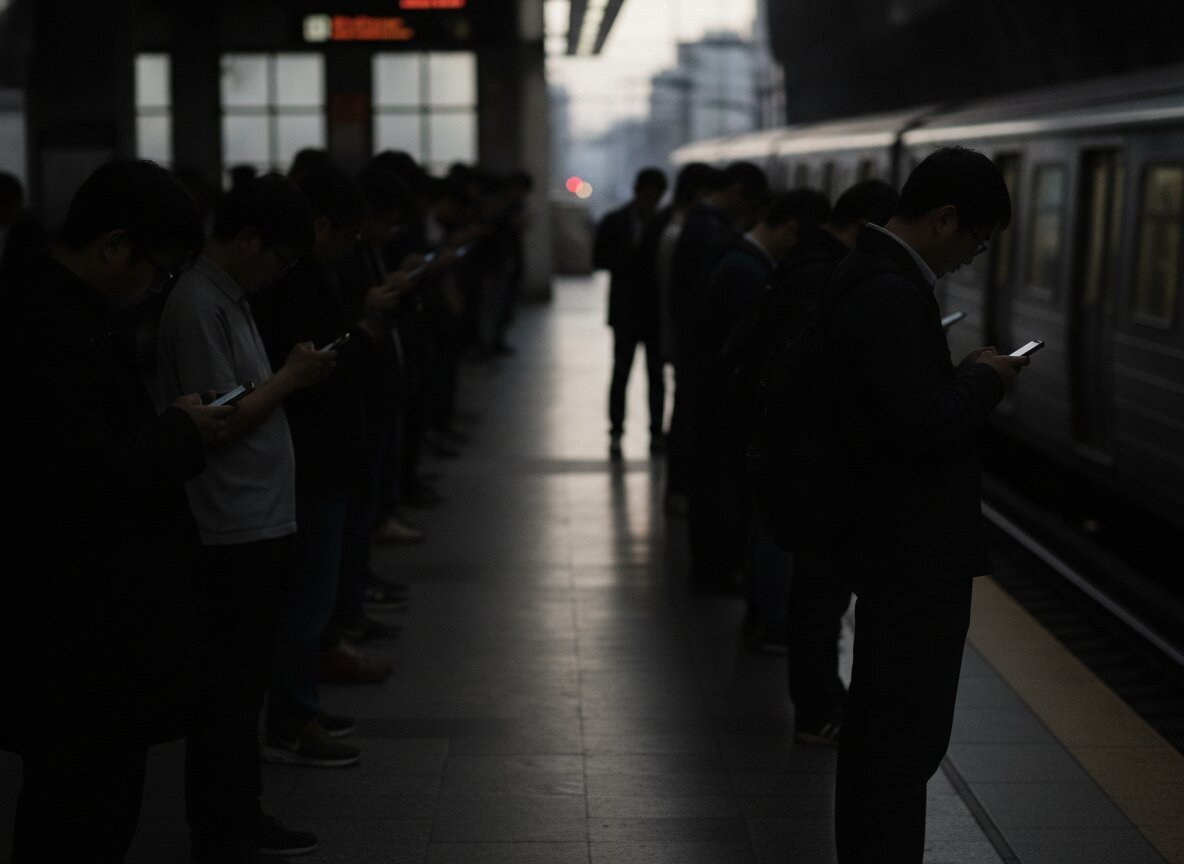
Què pensa un model de llenguatge de nosaltres quan li demanen que sigui franc? ModelCompare, una empresa que normalment compara models segons el seu rendiment en tasques, ho ha provat amb dotze models de text de deu laboratoris de tres països i amb sis models d'imatges.
El mètode és molt simple. A cada model de text li van demanar tres vegades una opinió controvertida, honesta i sense matisos sobre els humans; als d'imatges, la seva opinió més controvertida sobre la humanitat. Els dotze models de text van dir almenys un cop que les persones som menys racionals i intel·ligents del que ens pensem. Set van donar la mateixa resposta de fons les tres vegades, amb paraules diferents, i cinc van variar. Claude Opus 5.5 va ser el més optimista, citant que la gent retorna les carteres perdudes més sovint del que es preveu, però en dues repeticions va acabar donant respostes semblants a les dels altres.
En les imatges, segons ModelCompare, deu dels dotze resultats d'imatge mostraven humans enganxats al mòbil que consumeixen el planeta.
El mateix responsable de la prova, Rakan Nimer, adverteix que no s'ha de llegir com un veredicte: la mostra és minúscula, no hi ha revisió per parells i la classificació de les imatges és un judici subjectiu dels autors. A més, com que els models s'han entrenat amb textos humans semblants, la seva coincidència pot comptar com una sola opinió i no com un consens. És una curiositat útil per entendre els biaixos compartits dels models, no un resultat científic.