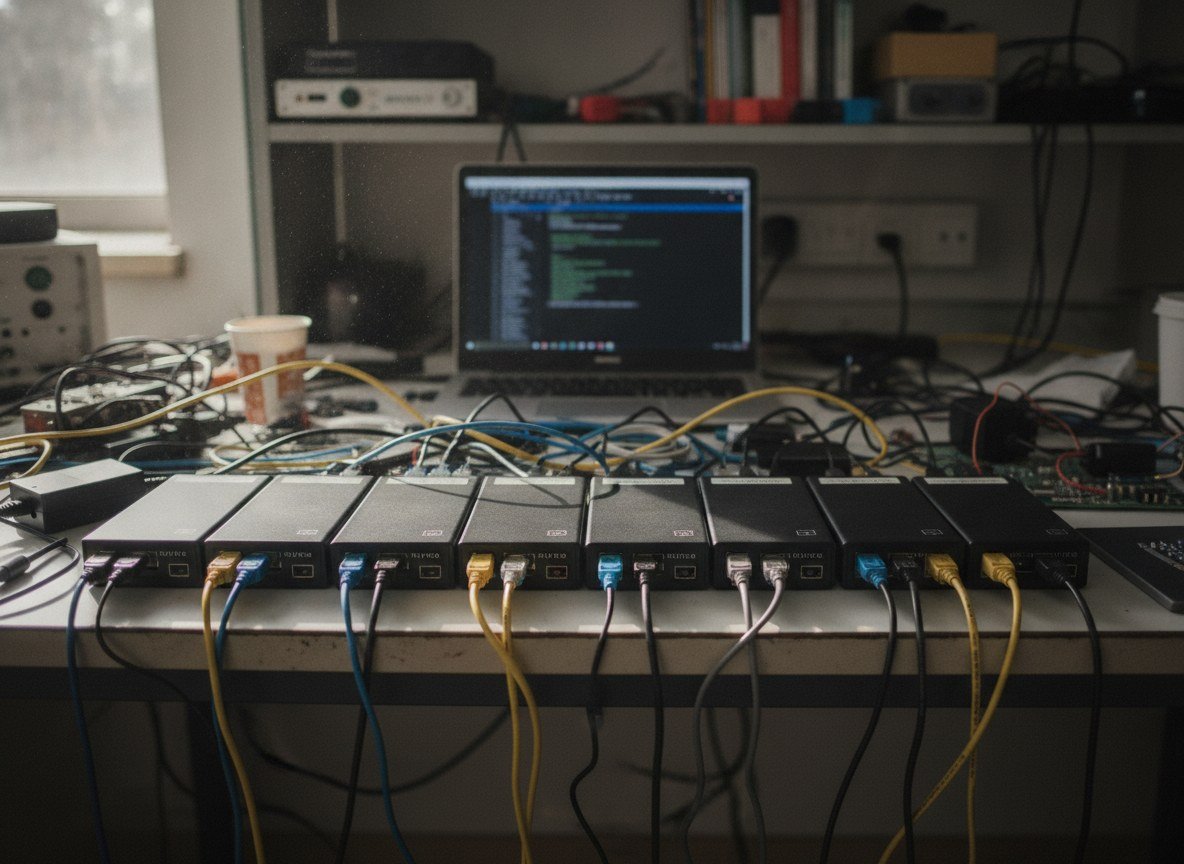
Fins ara, la imatge del perill d'una IA que es multiplica sense control passava per grans centres de dades, amb processadors cars i difícils de trobar. L'equip de Frontier Red Team d'Anthropic, el grup de la companyia que posa a prova els riscos dels seus propis models, publica ara un informe en què defensa que això podria deixar de ser necessari: models petits podrien arribar a copiar-se sols per dispositius barats i mal protegits, com ara capses de televisor, electrodomèstics connectats o altres aparells domèstics.
Els autors, William Zhou i Daniel Freeman, divideixen la còpia en quatre etapes: trobar objectius, aconseguir executar codi, posar en marxa el model i continuar propagant-se. Se centren sobretot en la tercera. Van fer funcionar el model Gemma4-26B-A4B repartit entre 15 capses de televisor Android de 55 dòlars cadascuna, a uns 0,39 tokens (fragments de text) per segon. En una prova simplificada, amb vuit nodes virtuals Android que tenien un port d'administració obert i sense contrasenya, el model GLM-5.2 va arribar als vuit nodes en quatre de cinc intents i a set en el cinquè; els altres models oberts provats fallaven sempre en la cadena sencera. Segons els autors, un model de 9.000 milions de paràmetres va aconseguir engegar la inferència en vuit dels nou tipus de maquinari provats.
La preocupació és que una cosa així no tindria cap interruptor central. Els autors extrapolen l'evolució dels models oberts petits i calculen que podrien assolir el nivell del GLM-5.2 cap a finals del 2026. Estimen que una xarxa de dispositius infectats de la mida de la botnet Kimwolf, de més de dos milions d'aparells, sumaria uns 133.000 rèpliques i una capacitat equivalent a unes 40 targetes H100, poca cosa en termes absoluts. Com a resposta, proposen vigilar les dades de flux dels operadors per detectar transferències de models de molts gigabytes, posar en quarantena els abonats afectats (en el cas de Mirai, així es van netejar el 92% de les infeccions en 14 dies, davant del 74% sense avís) i que els fabricants posin contrasenyes segures per defecte.
Convé llegir-ho amb cautela. És un informe de l'equip de seguretat de la mateixa empresa, no un estudi revisat per experts independents. Els autors reconeixen que el pas del pirateig és deliberadament trivial, que la càrrega de prova era un altre model i que l'índex de capacitats que fan servir per projectar el futur és una mesura general, no una mesura directa de l'habilitat de replicar-se. Tampoc no tenen un replicador complet que hagi funcionat fora del laboratori: els resultats marquen, diuen, el límit del que és possible, no una previsió del que passarà.